 Slovenščina
 Magyar
 English
 Deutsch



Load (obremenitev, angleško load average) je eden najpogosteje spremljanih kazalnikov sistemov Linux. Pokaže, koliko procesov je v povprečju hkrati hotelo delati: koliko jih je ravno teklo na procesorju ali čakalo na vrsto (izvedljivo stanje) in koliko jih je čakalo v nepreklicnem stanju, običajno na V/I diska ali omrežja (t. i. stanje D). Load torej ni odstotek in ne meri neposredno uporabe CPE, temveč „povpraševanje” po sistemu.
Tri številke
Vrednost load opisujejo tri številke, na primer:
load average: 1.20, 0.85, 0.60
To so eksponentno glajena povprečja zadnjih 1, 5 in 15 minut. Iz njihove primerjave se vidi trend: če je prva številka največja, obremenitev ravno narašča; če je najmanjša, prejšnja konica že pojenja.
Kako jo poizveš?
uptime
cat /proc/loadavg
nproc
Tri vrednosti izpišeta tudi uptime in prva vrstica ukaza top. nproc da število procesorskih jeder (na VPS vCPU), brez katerega obremenitve (load) ni mogoče razlagati. O uporabi top in htop govori naš članek o spremljanju procesov.
Kdaj je load visok?
Load vedno primerjaj s številom jeder:
- Na strežniku s 4 vCPU load 4 pomeni približno polno izkoriščenost: na vsakem jedru nekaj teče, a nihče ne čaka dolgo.
- Če je load trajno višji od števila jeder, procesi stojijo v vrsti in strežnik se odziva počasneje.
- Kratek, enominutni skok (na primer med opravilom cron ali varnostnim kopiranjem) sam po sebi ni slab; 15-minutna vrednost je merodajnejša.
Kaj lahko povzroči visok load?
Ker load šteje tudi procese, ki čakajo na V/I, je lahko CPE ob visokem loadu skoraj nedejavna. Zato vedno poglej, kaj je v ozadju:
- Obremenitev CPE: v izpisu
topsta vrednostiusinsyv vrstici%Cpu(s)visoki, eden ali več procesov porablja veliko CPE (na primer podivjan skript PHP ali spletna stran, ki jo obremenjuje promet robotov). - Čakanje na disk: vrednost
wa(iowait) je visoka, disk je ozko grlo. Povzroči jo lahko velika varnostna kopija, slabo indeksirana poizvedba v podatkovni bazi ali to, da je zmanjkalo pomnilnika in sistem uporablja swap. - Virtualizirano okolje: na VPS vrednost
st(steal) pokaže, koliko časa je navidezni računalnik čakal na fizični procesor.
Ukaz vmstat 1 vsako sekundo izpiše število tekočih (r) in blokiranih (b) procesov ter razdelitev časa CPE, kar pomaga ugotoviti, za kateri primer gre. Na testnem računalniku z AlmaLinux 10 z 2 vCPU, s tremi procesi, ki obremenjujejo procesor, in z nenehnim pisanjem na disk:
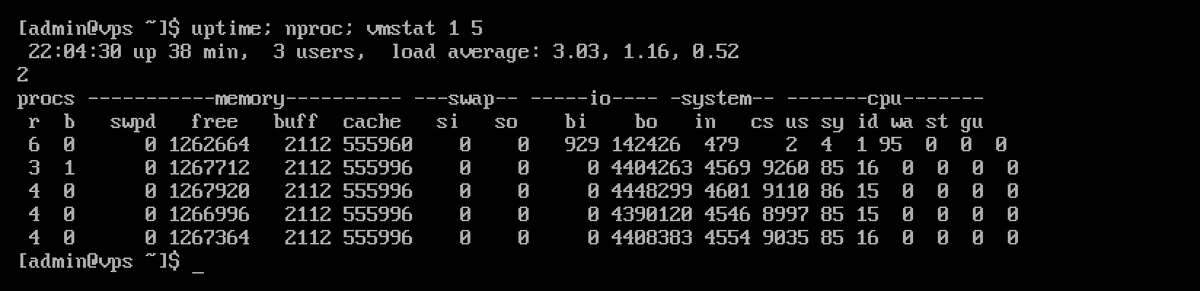
Load 3,03 na 2 jedrih pomeni, da je v povprečju en proces vedno čakal. V stolpcu r je na 2 jedri čakalo 3–6 procesov, čas nedejavnosti (id) je bil 0: to je ozko grlo CPE. Prva vrstica ukaza vmstat kaže povprečje od zagona sistema (tu še 95 % nedejavnega časa), resnično sliko dobiš od druge vrstice naprej.
Kaj narediti, če je trajno visok?
Najprej poišči in optimiziraj proces, ki povzroča obremenitev: s predpomnjenjem, z izboljšavo poizvedb v podatkovni bazi ali z redkejšim izvajanjem nepotrebnih opravil cron. Če je obremenitev sorazmerna s prometom in je strežnik za nalogo preprosto premajhen, lahko med paketi KVM VPS izbereš tudi večjo različico z več vCPU.