 Deutsch
 Magyar
 English
 Slovenščina


Das Hypertext Transfer Protocol (HTTP) ist ein Kommunikationsprotokoll, das für die Kommunikation zwischen Webservern (z. B. einer Website) und Clients (z. B. Ihrem Browser) im Internet verwendet wird.
HTTP funktioniert nach dem Client-Server-Modell: Der Client sendet eine Anfrage an den Server, und der Server schickt auf Grundlage der Anfrage eine bestimmte Antwort an den Client zurück. Diese Anfrage kann alles Mögliche sein, vom Abruf einer Webseite bis zum Anlegen eines Benutzerkontos mit einem angegebenen Benutzernamen und Passwort. Die einzelnen Anfragen sind unabhängig voneinander: Auf eine Anfrage folgt genau eine Antwort.
Neben HTTP begegnet uns in Webadressen häufig auch das Protokoll HTTPS. Das steht für Hypertext Transfer Protocol Secure und zeigt an, dass die Kommunikation durch eine zusätzliche Sicherheitsschicht geschützt ist, sodass böswillige Akteure sie nicht so leicht abfangen können. In einem früheren Beitrag über SSL haben wir erklärt, was das genau bedeutet und wie es funktioniert. Wichtig: Alles, was wir in diesem Artikel besprechen, gilt auch für HTTPS.
HTTP-Anfragen können vielen verschiedenen Zwecken dienen, die jeweils durch eine eigene sogenannte „Methode“ gekennzeichnet sind. Nur wenige dieser Methoden werden häufig verwendet, und diese sollte man kennen. Die gebräuchlichste ist die, mit der auch Sie zu diesem Blog gelangt sind: die GET-Methode. Wie der Name schon sagt, dient sie dazu, Informationen vom Server abzurufen. Ihr Browser hat eine solche Anfrage gesendet, als Sie auf einen Link geklickt haben, um diesen Artikel zu lesen – damit hat er das HTML dieser Webseite angefordert.
Wenn Sie zum Beispiel Informationen an einen Webserver senden möchten, um sich bei einem Konto anzumelden oder ein Formular auszufüllen, verwenden Sie die POST-Methode. Zwei weitere häufig genutzte Methoden sind PUT und DELETE. PUT ähnelt POST sehr, dient aber nicht dazu, neue Datensätze anzulegen, sondern vorhandene zu aktualisieren, und DELETE dient – wie Sie sich vielleicht schon denken können – dazu, das Löschen bestimmter Daten anzufordern.
Doch wie genau werden diese Methoden beim Senden einer Anfrage verwendet?
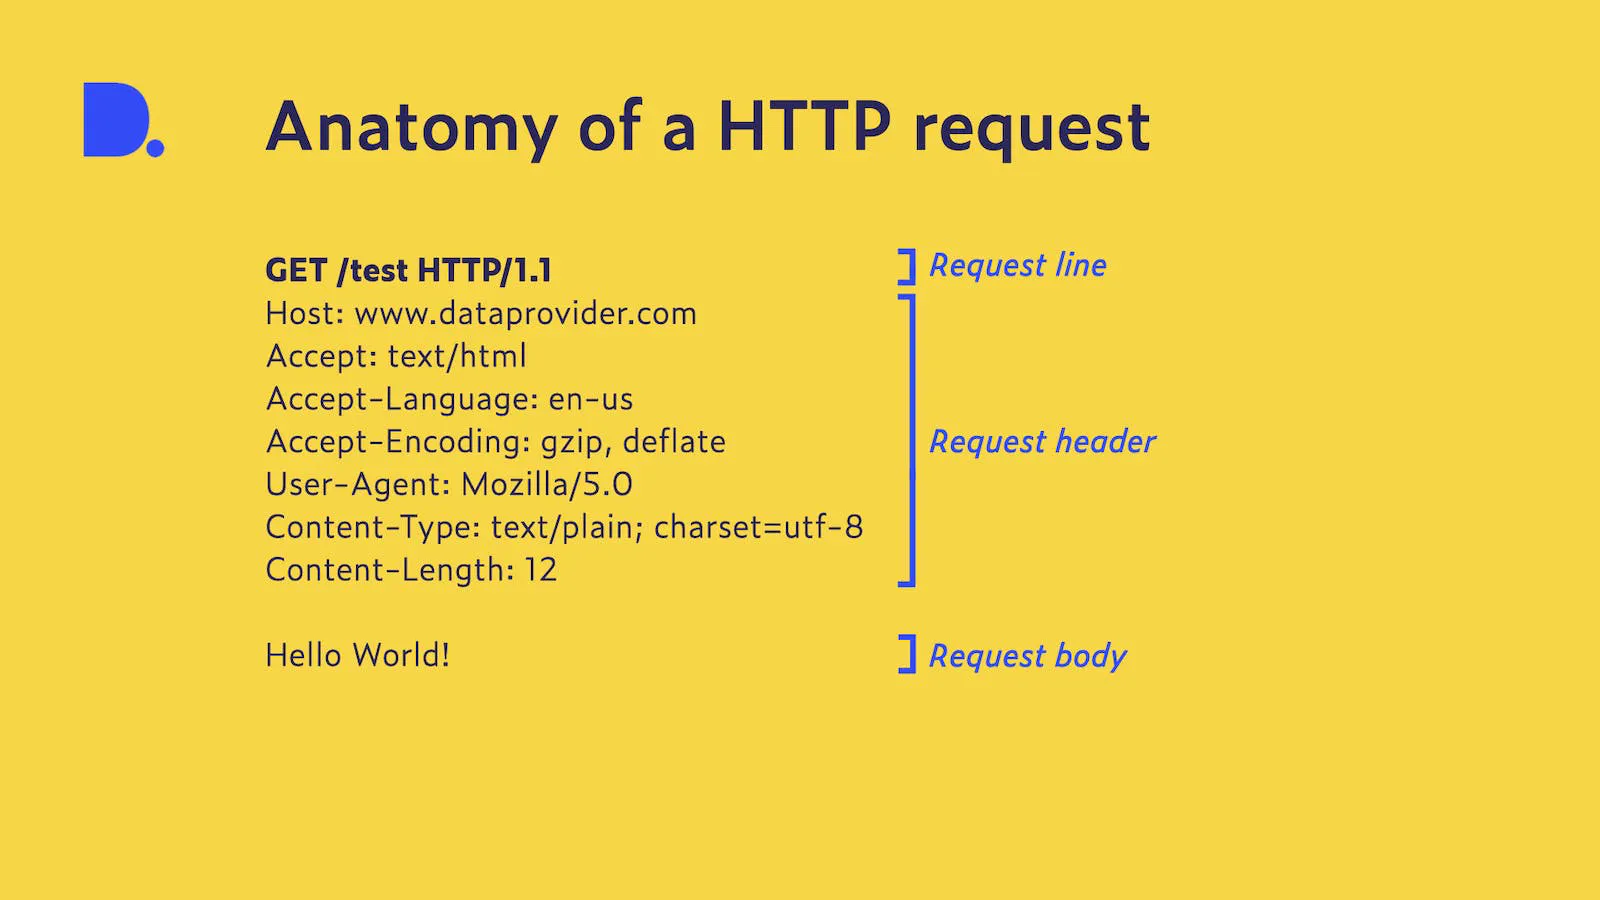
Die obige Abbildung zeigt eine HTTP-Anfrage in visueller Form. Das wirkt auf den ersten Blick vielleicht einschüchternd, aber wir zerlegen sie und sehen uns die einzelnen Teile an. Es handelt sich um eine Anfrage an einen Server, der den von uns übergebenen Text verarbeitet und uns in diesem Fall eine HTML-Seite mit unserem Text in einer Überschrift zurückgibt. Der erste Teil der Anfrage, die wir an diesen Server senden, ist die Anfragezeile (Request Line), die aus drei Bestandteilen besteht: der Methode, dem Ziel und der Protokollversion. Diese Zeile teilt dem Server mit, welche Aktion wir ausführen möchten, an welchem Ziel diese Aktion ausgeführt werden soll und – um Missverständnisse zu vermeiden – welches Protokoll genau wir für die Kommunikation verwenden möchten. In unserem Fall ist es eine GET-Anfrage, da wir eine HTML-Seite abrufen möchten. Diese Anfrage senden wir an den (fiktiven) Endpunkt /test und verwenden dabei das Protokoll HTTP in Version 1.1.
Als Nächstes folgen die Header. Die Header der Anfrage kann man als Metadaten betrachten, die den Server über die angeforderten Daten und den anfragenden Client informieren. Header lassen sich weiter in Kategorien unterteilen, das lassen wir hier aber außer Acht. In unserer Anfrage müssen wir mehrere Header übergeben, um dem Server mitzuteilen, wie unsere Anfrage beschaffen ist – über die Content-Header – und was wir als Antwort erwarten – über die Accept-Header. Der Host-Header sorgt dafür, dass die Anfrage beim richtigen Server ankommt.
Der User-Agent-Header teilt dem Server mit, welches Gerät und welchen Browser wir verwenden. Dieser Header sieht für jeden Gerätetyp anders aus, beginnt aber in der Regel mit Mozilla/5.0, um anzuzeigen, dass der Browser mit Mozilla kompatibel ist. Das ist nur eine kleine Auswahl der möglichen Header, die wir mit einer Anfrage übergeben können. Eine vollständige Übersicht finden Sie in der Mozilla-Dokumentation zu HTTP-Headern.
Zum Schluss folgt, durch eine einzelne Leerzeile von den Headern getrennt, der Body der Anfrage. Er ist optional, da nicht bei jeder Anfrage Inhalte an den Server gesendet werden müssen; in unserem Fall möchten wir aber etwas Text senden, der als Überschrift erscheint. Das ist ein sehr einfaches Beispiel – der Body einer Anfrage kann deutlich komplexer sein und sogar mehrere Ressourcen enthalten.
Nachdem der Server die Anfrage verarbeitet hat, sendet er eine Antwort zurück. War die Anfrage erfolgreich, kann die Antwort so aussehen:
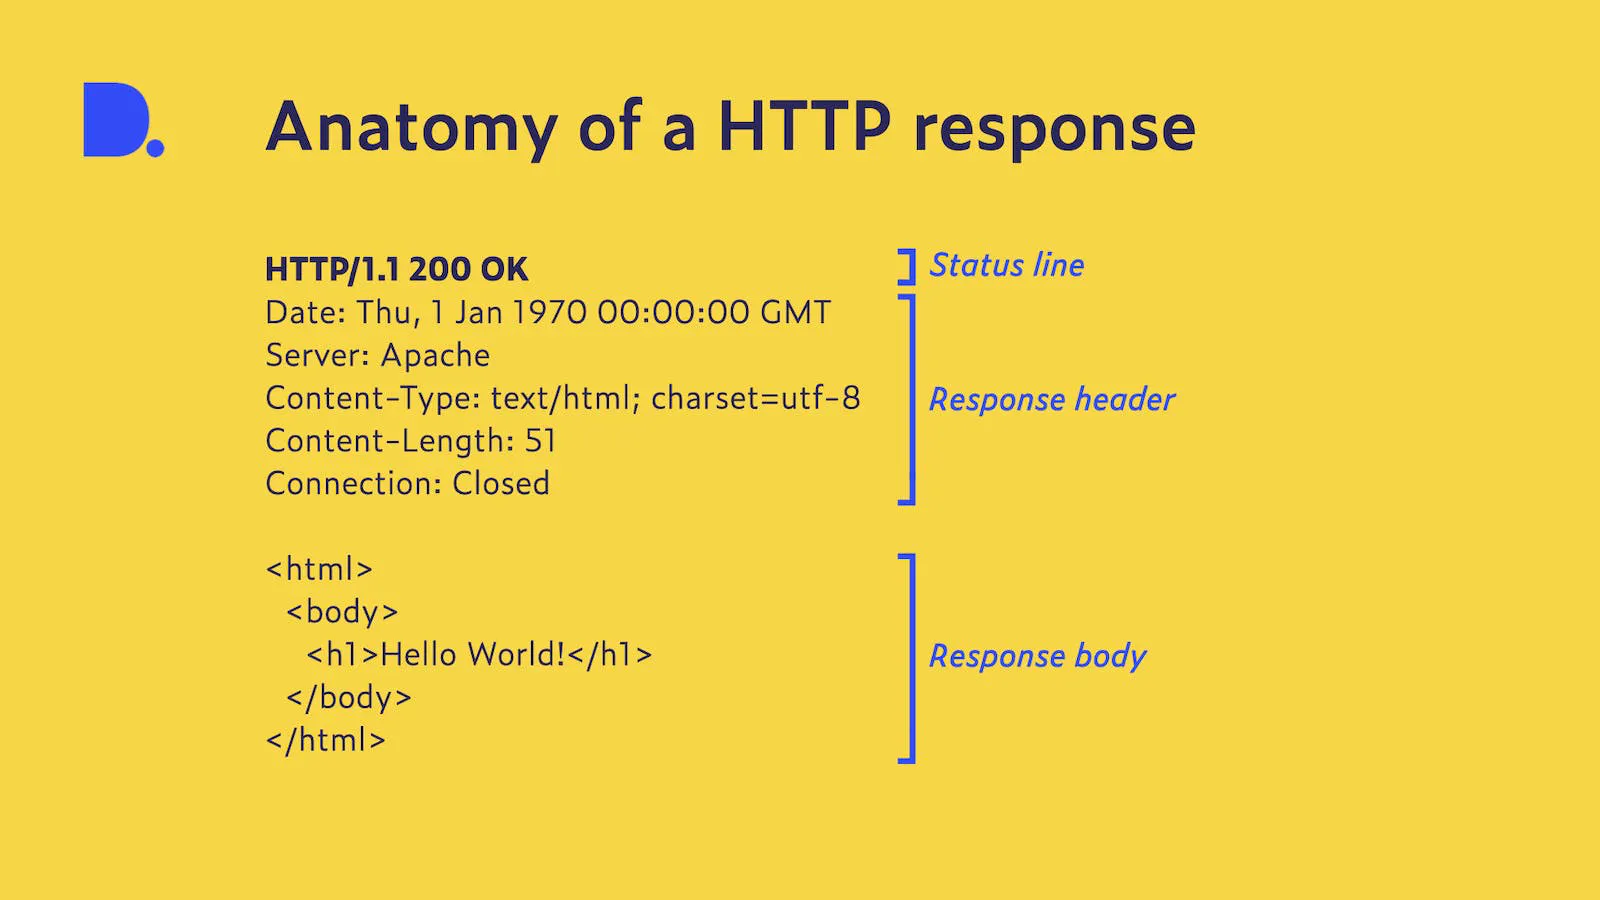
Eine HTTP-Antwort ist sehr ähnlich aufgebaut wie die Anfrage. Sie beginnt mit einer Statuszeile, die dem Client mithilfe eines Statuscodes und einer ergänzenden Statusmeldung mitteilt, welche HTTP-Version verwendet wird und wie die Anfrage behandelt wurde. Diese Statuscodes lassen sich in fünf Kategorien einteilen und zeigen Erfolg oder Misserfolg der Anfrage an. Da unsere Anfrage erfolgreich war, haben wir den Statuscode 200 mit dem Text „OK“ erhalten, was bedeutet, dass alles nach Plan gelaufen ist. Diesen und andere Statuscodes erfassen auch Web-Crawler, die für jede besuchte Website den Antwortcode und die Header speichern.
Auf die Statuszeile folgen die Antwort-Header, die Informationen über den Server und den zurückgesendeten Inhalt liefern. Dieser Inhalt ist wiederum durch eine Leerzeile von den Headern getrennt und enthält in unserem Fall die HTML-Struktur einer Webseite mit dem an den Server gesendeten Text in einer Überschrift.
Hoffentlich wissen Sie jetzt etwas mehr über die komplexe Natur des Internets und darüber, was hinter den Kulissen passiert, wenn Sie Ihren Lieblings-Rezeptblog besuchen oder Ihr LinkedIn-Profil aktualisieren.