 Deutsch
 Magyar
 English


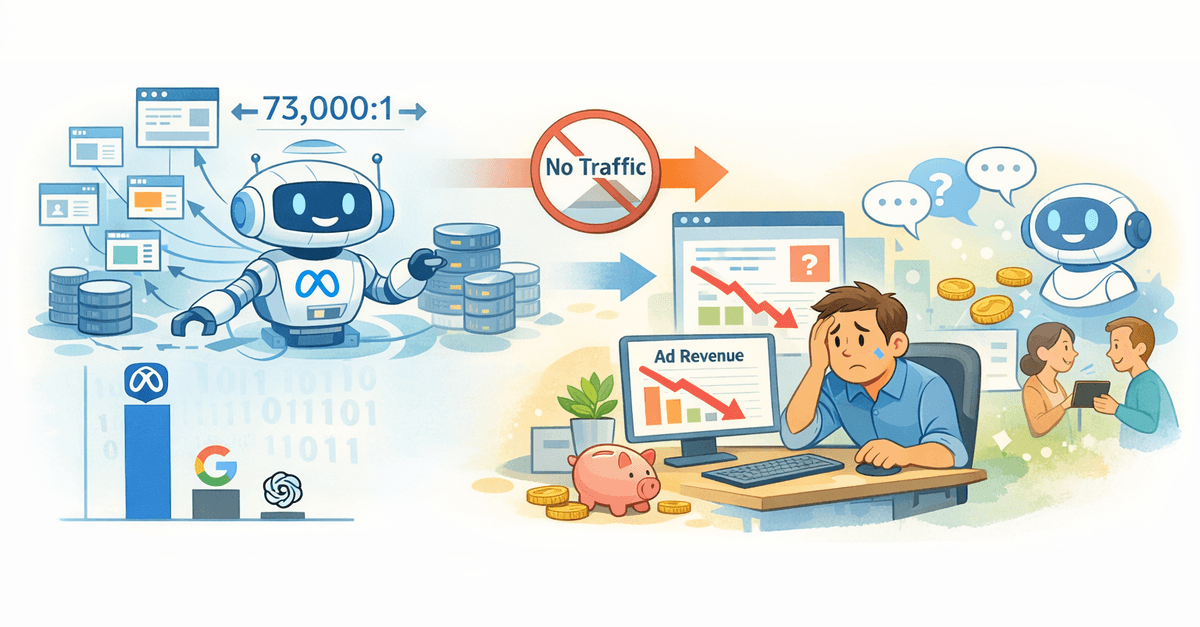
Unter „Meta-AI-Crawling“ versteht man den automatisierten Prozess, den Meta einsetzt, um auf den Inhalt von Websites zuzugreifen und diesen zu indexieren, mit dem Ziel, seine Modelle der künstlichen Intelligenz zu trainieren. Für Website-Betreiber, die auf Werbeeinnahmen angewiesen sind, ist es nicht mehr nur eine optionale Frage, zu verstehen, wie sich die Meta-KI blockieren lässt. Es handelt sich um eine geschäftliche Entscheidung, die erhebliche finanzielle Konsequenzen nach sich zieht.
Es steht viel auf dem Spiel. Laut Daten von Cloudflare vom Juli 2025 generieren die KI-Crawler von Meta allein 52 % des gesamten KI-Crawler-Traffics, was mehr als dem Doppelten des kombinierten Traffics von Google und OpenAI entspricht. Das Verhältnis von Crawls zu Weiterleitungen bei Meta liegt bei etwa 73.000:1, was bedeutet, dass Meta in außergewöhnlichem Maße Inhalte von seiner Website abruft, im Gegenzug jedoch praktisch keinen Traffic weiterleitet.
Dieses Ungleichgewicht unterbricht im Grunde genommen die traditionelle Beziehung zwischen Content-Erstellern und Suchmaschinen. Suchmaschinen haben Inhalte in der Vergangenheit mit dem Ziel der Traffic-Generierung indexiert. KI-Crawler nutzen Ihre Inhalte zum Trainieren von Modellen, die Ihren Traffic tatsächlich verringern können, indem sie Antwortmaschinen füttern, die Nutzer davon abhalten, auf Ihre Website zu klicken.
Wenn Sie abwägen, ob das Blockieren in Ihrer Situation überhaupt die richtige Strategie ist, finden Sie in unserem umfassenden Leitfaden für Publisher zum Thema KI-Crawler Informationen dazu, ob Sie diese blockieren, zulassen oder optimieren sollten, um maximale Einnahmen zu erzielen.
Die Welt der Meta-Suchroboter: Lernen Sie die Bots kennen
Meta betreibt mehrere Webcrawler, und die Unterschiede zwischen ihnen sind tatsächlich sehr groß. Wenn Sie wissen, wozu der jeweilige Crawler dient, können Sie vermeiden, dass dieser versehentlich Ihre Präsenz in den sozialen Medien beeinträchtigt, während Sie versuchen, Ihre Inhalte vor dem Training künstlicher Intelligenz (KI) zu schützen. Das Unternehmen war hinsichtlich seiner KI-bezogenen Crawler-Aktivitäten deutlich weniger transparent als andere Technologiegiganten. Im August 2024 startete Meta ohne offizielle Ankündigung stillschweigend den „meta-externalagent“, sodass es für Publisher äußerst schwierig war, zu verstehen, was dieser neue Bot auf ihren Servern eigentlich tat.
Vorstellung der wichtigsten Suchroboter von Meta
Hier erfahren Sie alles, was Sie über die derzeit aktiven Meta-Robots wissen müssen.
| Name des Suchmaschinen-Bots | User-Agent-Zeichenfolge | Hauptziel | Wird es für das Training von KI verwendet? | Auswirkungen einer Sperrung |
|---|---|---|---|---|
| facebookexternalhit | facebookexternalhit/1.1 | Erstellen einer Link-Vorschau zum Teilen auf Facebook, Instagram und im Messenger | Nicht eindeutig (möglicherweise doppelte Verwendung) | Die Deaktivierung führt zu Schwierigkeiten beim Teilen von Facebook-Beiträgen; das Vorschaubild lässt sich nicht laden. |
| meta-externalagent | meta-externalagent/1.1 | Training von Modellen künstlicher Intelligenz und Indizierung von Inhalten | Ja (bestätigt) | Das KI-Training wird eingestellt; dies hat keine Auswirkungen auf die Vorschau der Links |
| FacebookBot | FacebookBot/1.0 | Spracherkennung und Training von Sprachmodellen | Ja | Die Auswirkungen auf die Nutzer sind minimal |
| Meta-ExternalFetcher | Meta-ExternalFetcher/1.0 | Von einem KI-Assistenten ausgeführte Aufgaben | Ja | Dies wirkt sich auf die Suchfunktionen von Meta AI aus |
Der wichtigste Unterschied besteht hier zwischen „facebookexternalhit“ und „meta-externalagent“. Ersteres gibt es bereits seit Jahren und generiert jene ansprechenden Link-Vorschauen, wenn jemand Ihren Artikel auf Facebook teilt. Letzteres hingegen ist Metas eigener, auf künstliche Intelligenz spezialisierter Suchroboter.
So können Sie Meta AI mithilfe der robots.txt-Datei blockieren
Die robots.txt-Datei ist nach wie vor die gängigste Methode, um Suchmaschinen-Robotern die Präferenzen hinsichtlich der Indizierung einer Website mitzuteilen. Das Hinzufügen von Meta-spezifischen Anweisungen zu dieser Datei dauert etwa 30 Sekunden und erfordert keinerlei technisches Fachwissen. Diese Methode ist die am einfachsten umzusetzende Lösung für Website-Betreiber, wenn sie den Zugriff von Meta AI auf ihre Website verhindern möchten.
Grundlegende Anweisungen zum Blockieren von Meta-AI
Wenn Sie die Crawler von Metas künstlicher Intelligenz blockieren möchten, dabei aber die Vorschaufunktion für Links beibehalten wollen, fügen Sie folgende Zeilen in die Datei „robots.txt“ ein:
# Meta-AI-Crawler blockieren
User-agent: meta-externalagent
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: FacebookBot
Disallow: /

User-agent: Meta-ExternalFetcher
Disallow: /
Diese Einstellung blockiert KI-basierte Suchroboter, während sie es dem Suchroboter für die Link-Vorschau ermöglicht, seine Aufgabe auszuführen. Ihre geteilten Links werden auf Facebook und Instagram weiterhin gut dargestellt.
Das vollständige Verbot: Alle Meta-Zugriffe sperren
Manche Website-Betreiber möchten keinerlei Meta-Crawler einsetzen. Sollte dies auch auf Sie zutreffen, finden Sie hier einen umfassenden Blockiercode, mit dem Sie alle Meta-AI- und Social-Media-Crawler deaktivieren können:
User-agent: facebookexternalhit
Disallow: /

User-agent: meta-externalagent
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: FacebookBot
Disallow: /

User-agent: Meta-ExternalFetcher
Disallow: /

User-agent: Facebot
Disallow: /
Achtung: Wenn Sie dies umsetzen, werden Ihre geteilten Links furchtbar aussehen. Keine Bilder, keine Beschreibungen, nur reine URLs. Falls der Traffic aus den sozialen Medien für Ihre Werbeeinnahmen von Bedeutung ist, sollten Sie es sich gut überlegen, bevor Sie sich zu einem solch drastischen Schritt entschließen.
Das Vertrauensproblem der robots.txt-Datei
Hier fangen die Probleme an. Die „robots.txt“-Datei basiert im Wesentlichen auf einem Vertrauensprinzip“, und mehrere Website-Betreiber haben berichtet, dass die Suchroboter von Meta diese Anweisungen nicht immer beachten. Einige Webmaster haben dokumentiert, dass „meta-externalagent“ trotz der ausdrücklichen Verbote in der robots.txt-Datei weiterhin ihre Websites gecrawlt hat. Ein Website-Betreiber berichtete, dass er an einem einzigen Tag mehr als 148.000 Anfragen von Metas Suchroboter, der mit künstlicher Intelligenz arbeitet, erhalten habe, was praktisch zu einem Denial-of-Service-Zustand führte. Das Problem bei der Einhaltung der Regeln besteht darin, dass die robots.txt-Datei nicht unbedingt ausreicht. Möglicherweise sind Maßnahmen auf Serverebene erforderlich, um Meta-KI-Suchroboter tatsächlich zu blockieren. Für eine umfassende Darstellung aller verfügbaren Blockierungsmethoden bietet unser technischer Leitfaden zum Blockieren von KI-Robotern auf Ihrer Website alles, was Sie wissen müssen – von grundlegenden Anweisungen bis hin zu fortgeschrittenen Firewall-Konfigurationen.
Blockierung auf Serverebene: Wenn die Datei „robots.txt“ nicht ausreicht
Für diejenigen, die statt höflicher Bitten garantierten Schutz wünschen, sorgt die Serverkonfiguration für eine tatsächliche Durchsetzung. Diese Methoden senden Fehlermeldungen an die Suchroboter zurück, anstatt darauf zu vertrauen, dass diese die Datei „robots.txt“ lesen und befolgen.
Apache .htaccess-Konfiguration
Um die Meta-AI-Suchroboter auf Serverebene zu blockieren, fügen Sie folgende Zeilen in die .htaccess-Datei ein:
RewriteEngine On

# Block meta-externalagent
RewriteCond %{HTTP_USER_AGENT} meta-externalagent [NC]
RewriteRule .* - [F,L]

# Block FacebookBot
RewriteCond %{HTTP_USER_AGENT} FacebookBot [NC]
RewriteRule .* - [F,L]

# Block Meta-ExternalFetcher
RewriteCond %{HTTP_USER_AGENT} Meta-ExternalFetcher [NC]
RewriteRule .* - [F,L]
Oder in einer Regel:
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} ^.*(meta-externalagent|FacebookBot|Meta-ExternalFetcher).*$ [NC]
RewriteRule .* - [F,L]
Diese Einstellung gibt bei allen Anfragen, die diesen User-Agents entsprechen, den Fehlercode 403 „Forbidden“ zurück.
Nginx-Konfiguration
Bei Nginx-Servern tragen Sie dies bitte in den Serverblock oder in eine separate Konfigurationsdatei ein:
if ($http_user_agent ~* "(meta-externalagent|FacebookBot|Meta-ExternalFetcher)") {
    return 403;
}
Einige Systemadministratoren bevorzugen einen umfassenderen regulären Ausdruck, der auch die verschiedenen Varianten erkennt:
if ($http_user_agent ~* "(meta-externalagent|Meta-ExternalAgent|FacebookBot|Meta-ExternalFetcher|facebookexternalhit)") {
    return 403;
}
Cloudflare-Nutzer: Lösung mit nur einem Klick
Cloudflare hat im Juli 2024 die mit einem Klick bedienbare AI-Bot-Blockierfunktion eingeführt, und bereits mehr als eine Million Websites haben diese aktiviert. Diese Lösung erfordert keine technische Konfiguration.
Gehen Sie im Cloudflare-Dashboard zum Menüpunkt „Overview“. Aktivieren Sie die Option „Control AI crawlers“, um bekannte KI-Trainings-Bots – darunter auch die Crawler von Meta – automatisch zu blockieren.
Cloudflare bietet auch detaillierte Einstellungsmöglichkeiten, falls Sie bestimmte Bots blockieren, andere hingegen zulassen möchten. Darüber hinaus stellt die Plattform verwaltete robots.txt-Funktionen bereit, die unter dem Menüpunkt „AI Crawl Control“ automatisch die entsprechenden Anweisungen für KI-Crawler hinzufügen.
Alternative Strategien zum Schutz von Inhalten
Über das Blockieren hinaus stehen Website-Betreibern weitere Möglichkeiten zur Verfügung, den Zugriff von KI-basierten Suchrobotern zu steuern. Einige Website-Betreiber erkennen, dass es sinnvoller ist, KI-Tools dazu anzuregen, auf ihre Website zu verlinken, anstatt die KI vollständig zu blockieren – eine alternative Strategie, die tatsächlich Traffic generieren kann, anstatt den Zugriff zu verhindern.
Die Verwendung von Meta-Tags
Fügen Sie diese experimentellen Meta-Tags in den Kopfbereich Ihrer Seite ein. Diese signalisieren den von künstlicher Intelligenz gesteuerten Suchrobotern, dass Sie nicht möchten, dass Ihre Inhalte für maschinelles Lernen verwendet werden:
<meta name="robots" content="noai, noimageai">
Diese Tags sind nicht standardisiert und werden auf freiwilliger Basis verwendet, stellen jedoch eine neue Ebene der Kommunikation mit Systemen der künstlichen Intelligenz dar.